Энтузиасты нашли способ почти вдвое поднять скорость тензорных ядер у игровых видеокарт NVIDIA трёх поколений — GeForce RTX 20 (Turing), RTX 30 (Ampere) и RTX 40 (Ada Lovelace). Пайка, перепрошивка BIOS и разгон не нужны: ограничение снимается программно, ещё до загрузки драйвера. Ускоряются только ИИ-задачи, в играх ничего не меняется.
Что сделали
Проект называется gpu-unlock, он открытый и неофициальный, основной репозиторий ведёт разработчик под ником Zagitta. Это модуль ядра Linux: он загружается раньше штатного драйвера NVIDIA, меняет низкоуровневые настройки видеокарты, перезапускает её и отдаёт драйверу. По словам автора, после этого вдвое растёт темп выдачи инструкций для матричных операций, где входные данные в FP16 или BF16, а накопление идёт в FP32.
Именно эти операции у игровых GeForce были урезаны вдвое по сравнению с профессиональными картами на тех же чипах. Судя по результатам, урезание было программным, а не аппаратным. Для RTX 40 есть отдельная ветка проекта — gpu-unlock-ada от JustAResearcher.
Сколько это даёт в тестах
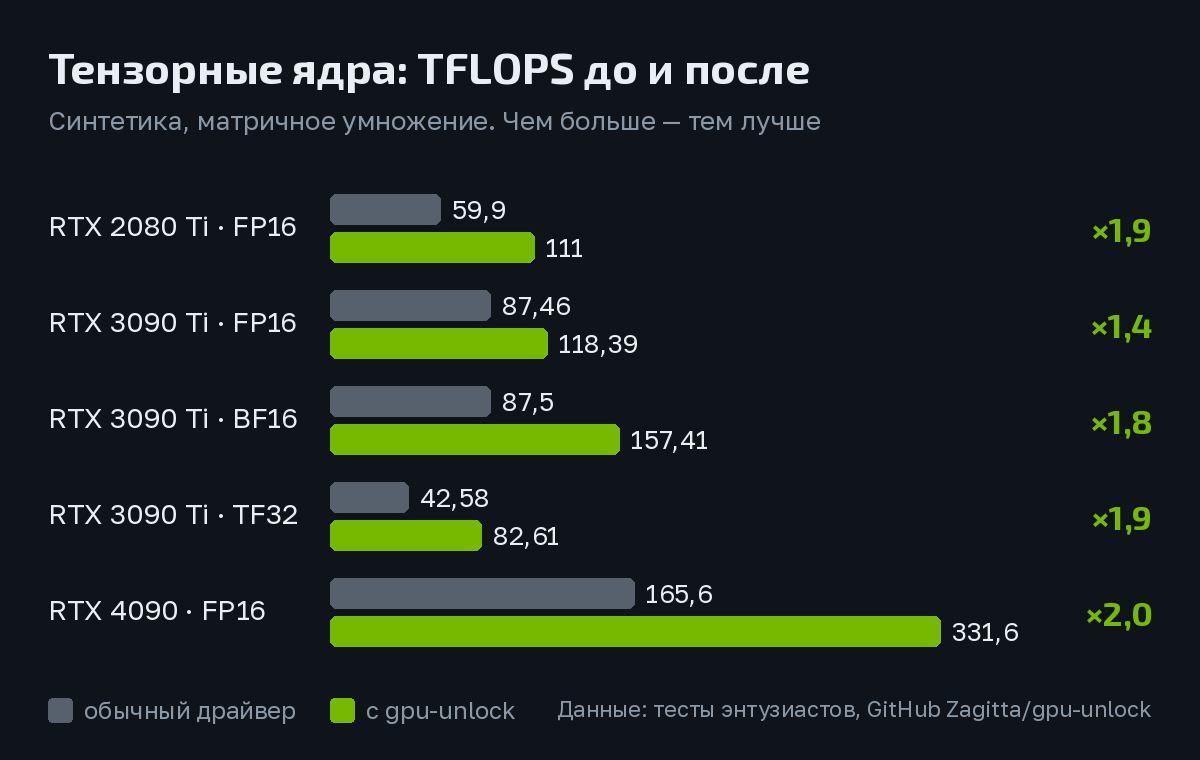
- RTX 2080 Ti, FP16 с накоплением в FP32: было 59,9 TFLOPS, стало 111 TFLOPS (×1,9).
- RTX 3090 Ti (лимит 450 Вт, медиана пяти прогонов): в FP16 было 87,5 TFLOPS, стало 118,4 TFLOPS; в BF16 было 87,5, стало 157,4 TFLOPS; в TF32 было 42,6, стало 82,6 TFLOPS.
- RTX 4090, FP16 с накоплением в FP32: было 165,6 TFLOPS, стало 331,6 TFLOPS — ровно вдвое. Но это одна карта, независимой проверки пока нет.
- RTX 4070 Ti SUPER поддерживается в экспериментальном режиме.
А в реальных программах
Удвоение TFLOPS не означает, что любая нейросеть заработает вдвое быстрее: часто узкое место — память, а не вычисления. Тесты на RTX 3080 это хорошо показывают.
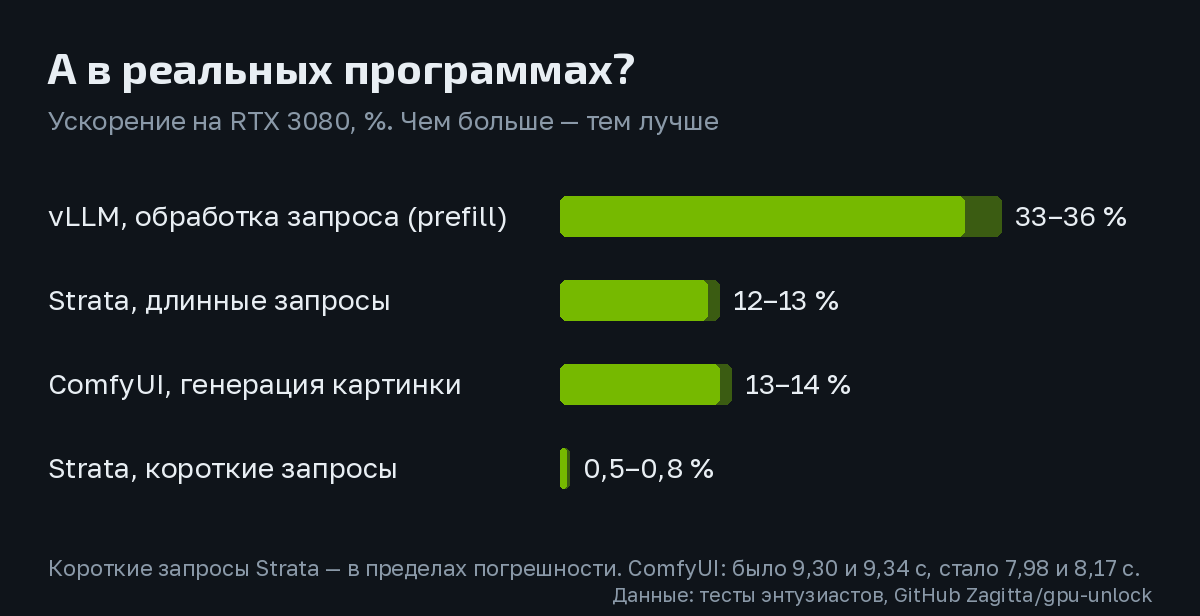
- vLLM, обработка запроса (prefill): быстрее на 33–36 %.
- Strata, длинные запросы: +12–13 %; короткие — +0,5–0,8 %, это в пределах погрешности.
- ComfyUI, генерация картинки: было 9,30 с, стало 7,98 с; в другом тесте было 9,34 с, стало 8,17 с — примерно на 13–14 % быстрее. Сами картинки при этом не изменились.
- Квантованные языковые модели в ряде тестов почти не ускорились.
Больше всего выигрывает обработка длинного запроса, генерация ответа (decode) ускоряется заметно меньше.
Ограничения
- Работает только в Linux. После полного отключения питания видеокарты настройки сбрасываются, модуль нужно загружать снова.
- Все результаты — от энтузиастов, на одной или нескольких картах, часть из них с доработанной памятью. На обычных картах цифры могут отличаться.
- Некоторые пользователи жалуются, что штатный драйвер успевает занять видеокарту раньше модуля.
- Это вмешательство в работу видеокарты в обход NVIDIA: используете на свой страх и риск.
Для игр новость ничего не меняет. Зато для тех, кто запускает локальные нейросети на старых RTX 2080 Ti, RTX 3090 или RTX 4090, это может оказаться бесплатным ускорением — если подтвердится на большем числе карт.
Проект: github.com/Zagitta/gpu-unlock, ветка для RTX 40: github.com/JustAResearcher/gpu-unlock-ada.